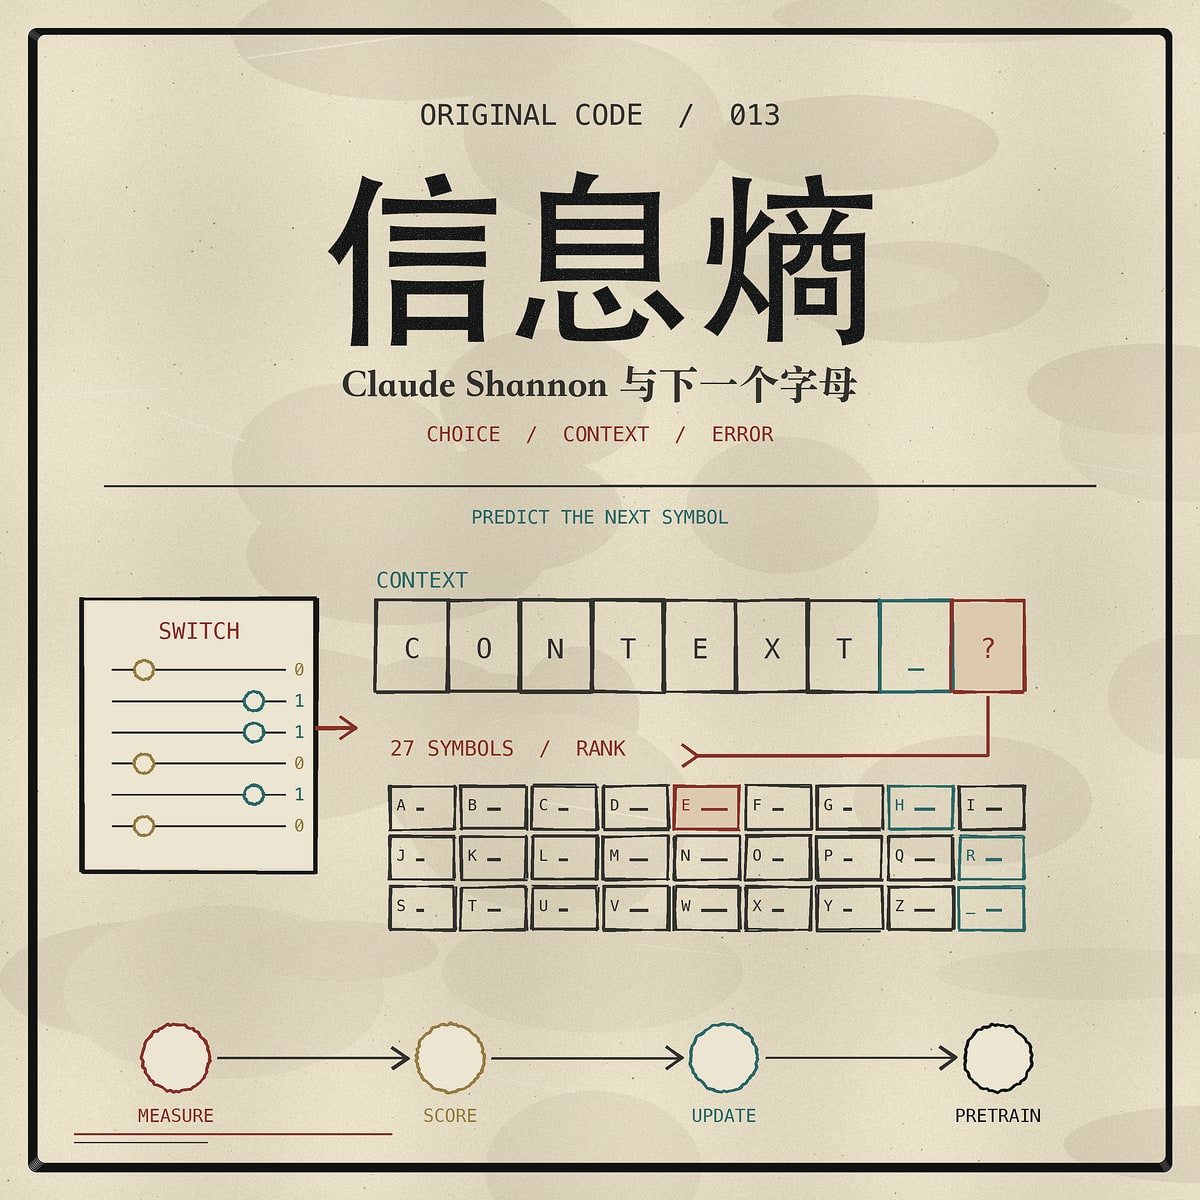
信息熵:Claude Shannon 与下一个字母
一台完全不理解句子含义的机器,能不能只根据已经出现的字符猜中下一个字符?本期《原代码》从 Claude Shannon 在 MIT 面对复杂继电器线路的场景出发,经过一九四八年把消息写成概率选择、一九五一年让人逐字符猜测英语,再沿 Weaver 的机器翻译设想、IBM 统计语言模型、神经概率语言模型和生成式预训练,追问同一个预测错误怎样从测量语言,变成评价模型、修改表示和预训练参数的入口。
从继电器上的一次开与关,到聊天窗口里的下一个 token:数学让两者都能被写成选择、条件和概率。中间近九十年的研究不断改变预测者、表示和误差用途,却没有让概率自动回答语言为何有意义、机器是否理解自己生成的文字。
本期逐字稿、证据引用关系和证据快照可在《原代码》官方网站 https://yuandaima.xyz 查看。
时间轴
00:00 在微分分析机旁认识 Shannon:机器很大,选择很小
01:38 把消息写成概率选择,先把语义放到模型外
04:15 翻一本书,生成越来越像英语的乱码
06:36 Weaver 把上下文与统计带进机器翻译问题
08:46 正确字符排在第几次:一九五一年猜字实验
12:31 预测者从人变成模型,交叉熵开始评价模型
14:50 猜错以后,词表示和网络参数也会改变
17:01 预测误差进入预训练,下一 token 仍只是系统入口
21:26 如果 Shannon 坐到今天的聊天窗口前
本期资料
访谈与历史原声来源
本版没有剪入第三方历史原声。IEEE History Center 页面证明 Claude Shannon 1982 口述史与本人声音入口存在,但没有片段同时通过出版许可、上下文、人工句界复听和权利门禁。
说明与延伸阅读
- 一九四八年论文建立通信、熵和随机英文近似;一九五一年论文才使用人类逐字符猜测估计英语熵,实验不是机器训练。
- 语义被放到通信工程模型之外,不代表意义不存在;低熵也不直接等于有意义、高质量或被理解。
- 一九五一年论文没有给
the subject 具名,不能自行把 Mary E. Shannon 写成唯一受试者。
- Weaver 与 Brown 直接点名 Shannon;Bengio 2003 和生成式预训练论文只支撑方法 / 指标继承或方法汇流,不构成逐篇直接引用的发明链。
- 下一 token 预训练不足以解释当前聊天系统的全部行为,也不能单独证明理解;Shannon 没有留下对 LLM 的实际评论。